記事ポイント
- 「Ozaki Scheme II」がCUDA Toolkit 13.4に搭載
- AI向け低精度計算で倍精度計算を高速化
- 富岳NEXTや米国科学研究プログラムでも注目
芝浦工業大学システム理工学部の尾崎克久教授らが考案した計算手法「Ozaki Scheme II(尾崎スキームII)」が、NVIDIA社のGPU開発基盤「CUDA」に採用されました。
2026年9月に公開された最新版「CUDA Toolkit 13.4」に搭載されています。
AI向けに進化した低精度計算を活用し、科学シミュレーションに必要な倍精度計算の性能を引き出す技術です。
芝浦工業大学 尾崎克久教授らの計算手法「Ozaki Scheme II」
- 搭載時期:2026年9月公開の最新版「CUDA Toolkit 13.4」に搭載
- 対応環境:NVIDIA Ampere世代以降の既存GPU上でソフトウェアとして動作
- B200 GPUでの性能:実数の倍精度行列積(DGEMM)で最大175 TFLOPS、複素数(ZGEMM)で最大295 TFLOPS
- Rubinでの性能:実数で最大212 TFLOPS、複素数で最大301 TFLOPS。CUDA 13.4におけるRubin対応は開発者向けプレビュー
芝浦工業大学システム理工学部の尾崎克久教授らが考案した計算手法「Ozaki Scheme II(尾崎スキームII)」が、米NVIDIA社のGPU開発基盤「CUDA」に採用されました。
AI向けの低精度計算を数学的に組み合わせ、高精度な計算を大幅に高速化する技術です。
尾崎克久教授らが開発した計算手法「Ozaki Scheme I」が2025年にNVIDIA CUDAに搭載されたのに続き、原理の異なる新方式「Ozaki Scheme II」が2026年9月に新たに採用されました。
近年のGPUは、AI開発向けに低精度計算を高速化する方向で進化しています。
一方、気象予測や耐震設計、新材料開発などの科学シミュレーションでは、倍精度の正確な計算でハードウェア性能を十分に引き出しにくい課題がありました。
背景として、AI向けGPUで倍精度演算が後退するなか、計算機シミュレーションでは数値の桁数を多く扱う「倍精度計算(FP64)」が精度の担保に不可欠です。
しかし近年のGPUは、AIの学習・推論に特化した低精度計算の処理能力を優先して向上させています。
NVIDIA社のBlackwell世代では、B200が約40 TFLOPSの倍精度性能を備えるのに対し、後継のBlackwell Ultra(B300)は1.2~1.3 TFLOPSと、30分の1以下に低下したことが報告されています。
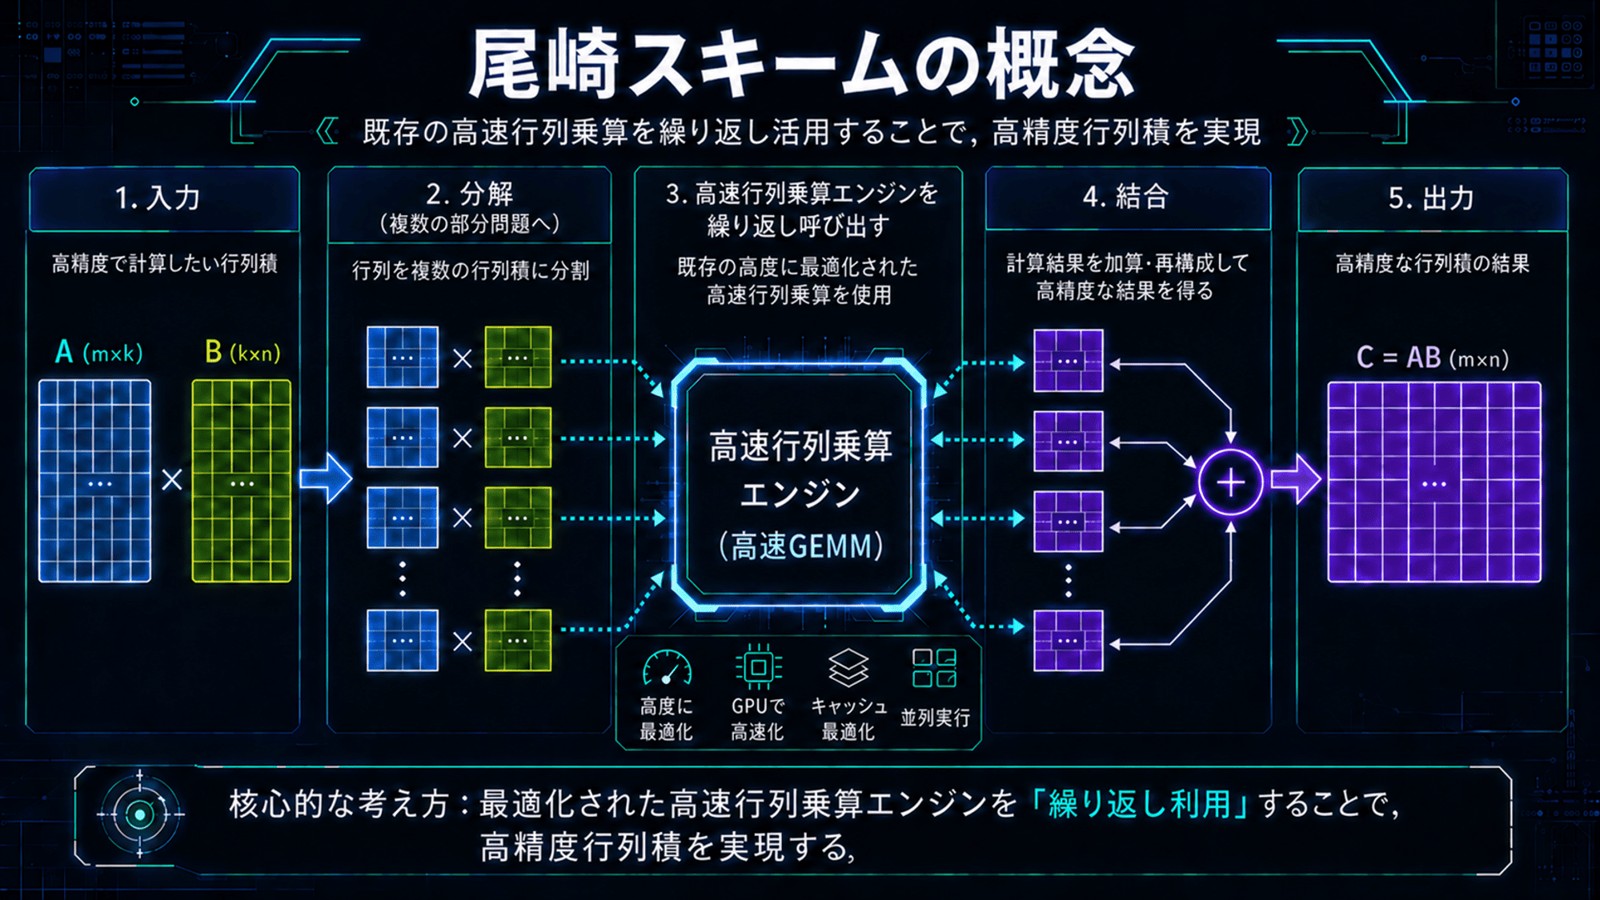
Ozaki Schemeは、AI向けの低精度計算能力を誤差なし変換や整数の余りを活用したモジュラー計算などの数学的アプローチで複数回組み合わせ、倍精度計算と同等の精度の結果を高速に導き出す技術です。
概念図では、既存の高速行列乗算を繰り返し活用し、高精度行列積を実現する考え方が示されています。
入力した行列積を複数の部分問題へ分解し、高速行列乗算エンジンを繰り返し呼び出してから結合し、高精度な結果を得る流れです。
倍精度計算だけでは使われない低精度の演算器を活用できるため、AI向けに強化された性能を科学技術計算へ振り向けられます。
科学シミュレーションに必要な倍精度計算の性能を、AI向けに進化した最新GPUから高い水準で引き出す技術とされています。
気象予測、耐震設計、量子化学計算、新材料開発など、高い精度が求められる分野の計算基盤を支えます。
14年越しの基礎研究が結実し、尾崎教授らは2012年に最初の手法「Ozaki Scheme I」を発表しました。
この手法では、計算誤差を数学的に扱う「誤差なし変換」に基づくアルゴリズムを確立しています。
2025年には、尾崎教授が理化学研究所の内野佑基氏、今村俊幸氏との共同研究により、新方式「Ozaki Scheme II」を発表しました。
Ozaki Scheme IIは整数の剰余、中国剰余定理を用いる方式で、Ozaki Scheme Iとは原理が異なります。
2025年10月には、NVIDIA社がCUDAのcuBLASにOzaki Scheme Iによるエミュレーション機能を実装しました。
以降、世界中の研究環境で利用できる機能として提供されています。
2026年には、Ozaki Scheme IIの論文が国際学術誌「The International Journal of High Performance Computing Applications」に掲載されています。
2026年9月、「CUDA Toolkit 13.4」にOzaki Scheme IIが正式採用されました。
NVIDIA社のアルゴリズムにより、ワークロードに応じて自動的に最適な方式が選択されます。
NVIDIA社のcuBLASリリースノートによると、Ozaki Scheme IIはNVIDIA Ampere世代以降のGPUに対応し、Ozaki Scheme Iより高速な場合に自動的に選択されます。
B200 GPUでは、実数の倍精度行列積(DGEMM)で最大175 TFLOPS、複素数の場合(ZGEMM)で最大295 TFLOPSを達成しています。
次世代アーキテクチャ「Rubin」では、それぞれ最大212 TFLOPS、301 TFLOPSとされています。
TFLOPSは、1秒あたり1兆回の計算を表す単位です。
本技術は、社会や産業界にも広がりを見せています。
理化学研究所は、2026年3月公開の次世代スーパーコンピュータ「富岳NEXT」開発状況資料で、数値計算ライブラリ開発の方向性として「FP64行列演算エミュレーション技術(Ozaki Scheme)による低精度演算器の活用」を挙げています。
「富岳NEXT」はスーパーコンピュータ「富岳」の後継機で、富士通・NVIDIAとの連携により2030年ごろの稼働を目指しています。
HPC専門メディアHPCwireは2026年2月、米国エネルギー省(DOE)が進める科学研究プログラム「Genesis Mission」が、必要とする倍精度計算能力の確保をOzaki Schemeによるエミュレーションに大きく依存する見通しであると報じています。
理化学研究所 計算科学研究センターの松岡聡センター長は2026年の論文で、Ozaki Scheme IIを中核とする方式により主要な計算処理で倍精度の精度を保ったまま性能を回復できると論じています。
NVIDIA社は、このFP64エミュレーションが性能と電力効率の双方を改善するとしています。
電力はスーパーコンピュータ運用上の大きな制約であり、計算基盤の持続可能性にも関わる要素です。
Ozaki Schemeが現在対象としているのは、シミュレーション処理の中核である「行列計算」です。
NVIDIA社は、連立方程式や固有値計算を担う上位ライブラリにも同じ仕組みの導入を始めており、適用できる計算の範囲は広がりつつあります。
少ない電力で高い精度の計算が得られるようになれば、一般的なGPUを備えた大学の研究室や中小規模の企業でも、これまでにない規模のシミュレーションに挑めるようになると期待されており、芝浦工業大学は今後も社会課題の解決を支える計算科学・数値解析の研究を推進していくとしています。
関連論文として、2012年に「Error-Free Transformations of Matrix Multiplication by Using Fast Routines of Matrix Multiplication and its Applications」が発表されています。
Ozaki Scheme IIについては、2026年に「Ozaki scheme II: A GEMM-oriented emulation of floating-point matrix multiplication using an integer modular technique」が掲載されました。
計算基盤をめぐる議論では、2026年の査読前プレプリント「FP8 is All You Need (Part 1): Debunking Hardware FP64 as the HPC Holy Grail」も示されています。
芝浦工業大学は、工学部、システム理工学部、デザイン工学部、建築学部、大学院理工学研究科を有する大学です。
理工系大学として、学生海外派遣を含むグローバル教育や、学生が参画する産学連携の研究活動を特徴としています。
東京都の豊洲と埼玉県の大宮に2つのキャンパスがあり、約10,000人の学生と約300人の専任教員が所属しています。
2024年には、工学部が学科制から課程制へ移行しました。
2025年にデザイン工学部、2026年にはシステム理工学部で教育体制を再編し、新しい理工学教育のあり方を追求しています。
創立100周年を迎える2027年にはアジア工科系大学トップ10を目指し、教育、研究、社会貢献に取り組んでいます。
芝浦工業大学は今後も、社会課題の解決を支える計算科学・数値解析の研究を推進していくとしています。
よくある質問
Q. 「Ozaki Scheme II」は何に採用されましたか?
A. NVIDIA社のGPU開発基盤「CUDA」に採用され、2026年9月公開の「CUDA Toolkit 13.4」に搭載されています。
Q. どのような計算を高速化する技術ですか?
A. AI向けの低精度計算を数学的に組み合わせることで、科学シミュレーションに必要な高精度計算を大幅に高速化する技術です。
Q. Ozaki Scheme IIは新しい演算回路を追加する技術ですか?
A. 新たな演算回路を追加するものではなく、NVIDIA Ampere世代以降の既存GPU上でソフトウェアとして動作します。
Q. どの分野の計算基盤を支える技術ですか?
A. 気象予測、耐震設計、量子化学計算、新材料開発など、高い精度が求められる分野の計算基盤を支える技術です。